
一、為什麼今天不教新東西
連續十四天的高密度輸入之後,繼續往前衝的邊際效益其實在下降——新知識會開始蓋掉還沒站穩的舊知識。學習和負載測試意外地像:一路爬升不留平穩期,你量不到系統真正的水準。今天就是刻意安排的平穩期:回顧、鞏固、驗收,把「做過一次」變成「隨時做得出來」。
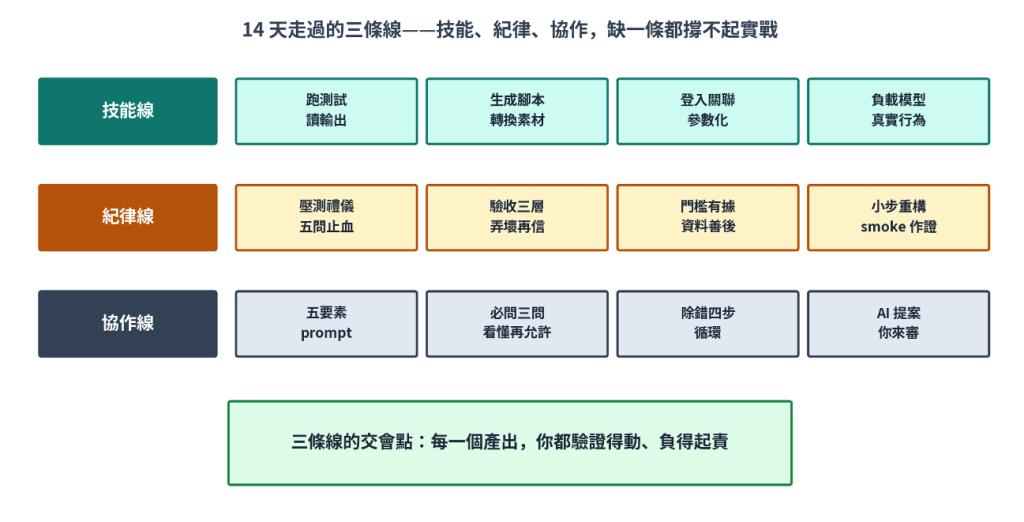
圖 1:14 天的三條線——技能、紀律、協作;交會點是「每個產出你都驗證得動、負得起責」
值得注意的是:這三條線裡,真正花時間的從來不是技能線——腳本有 AI 代勞。紀律線與協作線才是這兩週的主要投資,而它們正是 AI 代勞不了的部分。
二、動手做一:請 Claude Code 全面審查你的作品
兩週的腳本經過 Day 14 的整理已經有了結構,現在做一次品質總驗收。這次的 review 不是漫無目標的「幫我看看」,而是拿著明確的標準去審:
Prompt 1|依標準全面 review
請審查這個資料夾所有的 k6 腳本,逐項檢查以下標準,
輸出一份審查報告(依嚴重度排序,註明檔名與行數):
1. 需求五要素是否完整且有註解說明
2. 是否有 think time,且經過隨機化
3. check 是否至少涵蓋狀態碼;thresholds 是否有訂
4. 有沒有寫死的機密或網址(應走環境變數)
5. URL 帶參數處是否已做統計分組;group 名稱是否固定
6. 測試資料是否參數化;唯一值是否帶可辨識前綴
7. 寫入型操作是否有清理策略
只回報問題與建議,先不要修改任何檔案。
拿到報告後的動作和 Day 14 審整理計畫一樣:逐條判斷同不同意,同意的排序處理(每修一條跑一次 smoke),不同意的想清楚理由——能對 AI 的審查意見說出「這條我不改,因為…」,代表你對自己的腳本有了主見,這是兩週前做不到的事。
三、動手做二:沉澱你的檢查清單
剛才 review 用的標準,其實就是這兩週所有教訓的濃縮。把它固化成檢查清單,之後每支新腳本誕生時走一遍——品質不再靠記性,靠流程:
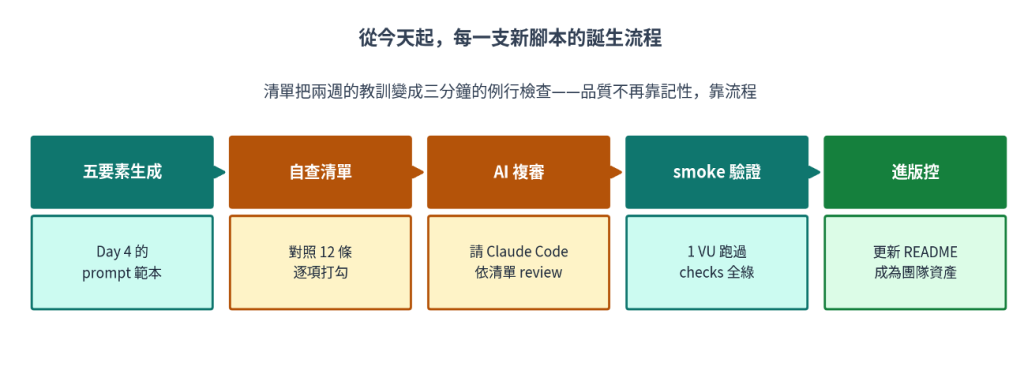
圖 2:新腳本的誕生流程——生成、自查、AI 複審、smoke、進版控
Prompt 2|生成檢查清單檔案
請建立 checklist.md:「效能測試腳本檢查清單」,
內容用我提供的 12 條(見下方),格式為可勾選的核取清單,
每條後面加一行小字說明「為什麼重要」。繁體中文。
12 條清單全文(也收錄在附錄,方便影印):
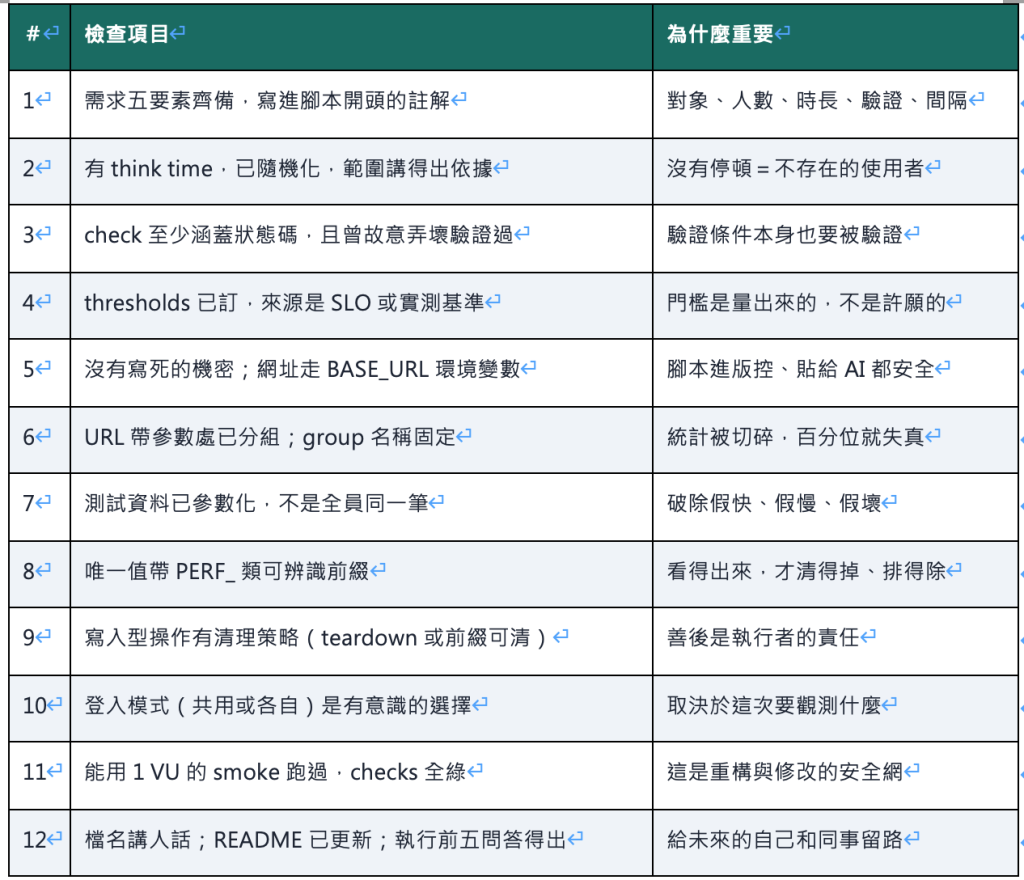
用法有兩層:自己寫或生成新腳本後,人工走一遍打勾;接著把清單交給 Claude Code 複審(「請依 checklist.md 審查這支腳本」)。人查一次、AI 查一次,兩道網——清單本身也會演化,之後學到新教訓就加一條。
四、動手做三:14 題快問快答
每天一題,答得出來就過,卡住的就是回去翻的訊號。不用寫下來,心裡過一遍:
• Day 1:效能測試要回答的三個問題是什麼?
• Day 2:AI 協作時代選程式碼工具而非 GUI 工具,最核心的理由?
• Day 3:Claude Code 跳出權限請求時,正確的反應是什麼?
• Day 4:生成腳本後必問的三問是哪三問?
• Day 5:avg 明顯大於 med,代表數據長什麼樣?
• Day 6:壓測前五問是哪五問?
• Day 7:check 和 threshold,誰是觀察員、誰是裁判?
• Day 8:從瀏覽器複製的 curl 貼給 AI 前,必須先刪什麼?
• Day 9:連按兩次 Ctrl+C 強制中斷後,為什麼要人工補清理?
• Day 10:三個月前錄的請求重播全變 401——為什麼?
• Day 11:除錯四步循環是哪四步?
• Day 12:breakpoint 測試必須搭配哪個機制?為什麼?
• Day 13:沒有 sleep 的腳本,測的是什麼樣的使用者?
• Day 14:重構的安全網是什麼?它把最壞情況變成了什麼?
十四題全過的人,兩週的地基是穩的。卡三題以上也完全正常——回去翻對應那天的「觀念驗證」段落,比重讀全文有效率。
五、誠實盤點:你現在還不會什麼
回顧不只盤點會的,也要誠實面對還不會的——知道邊界在哪,才不會在職場上接下超出能力的承諾:
• 拿到「p95 太慢」之後,判斷瓶頸可能在哪一層——目前你會看數字,還不會推理數字背後的系統
• 面對「老闆只說要快」,把模糊期待變成可測量的效能需求
• 把一堆數字寫成一份能說服人的報告,以及開一張會被認真對待的效能缺陷單
• 測試環境規格只有正式環境一半時,數字該怎麼解讀
這些正是下一階段的主軸:從「會做測試」走向「會判讀、會溝通、會說服」——測試人員在效能測試裡真正的核心價值。工具的部分你已經齊了,接下來練的是判斷力。另外有一件事永遠不在本系列範圍:把慢的系統修快。那是 RD 的專業——你的專業是用可信的數據,告訴團隊哪裡值得修。
六、兩週後最容易養成的壞習慣
熟練會帶來捷徑,捷徑會腐蝕紀律。四個最常見的滑坡,現在自我檢核一次:
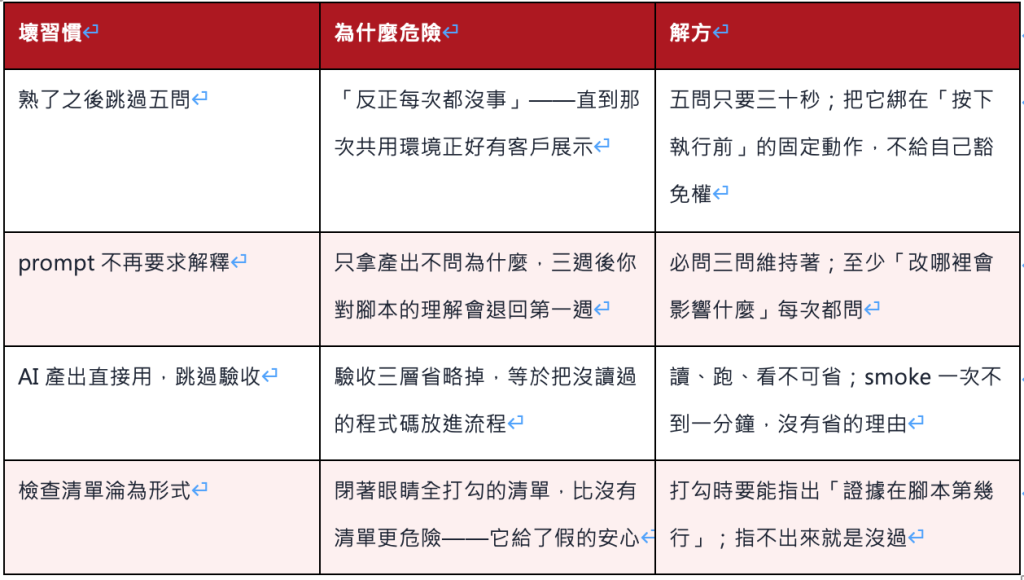
給 RD 的一句話:如果團隊裡的 QA 跟著這系列走到今天,他手上有:一套整理過的腳本、一份 12 條檢查清單、一個有紀律的 AI 協作流程。這是可以直接接進團隊工程實踐的狀態——下次 sprint 規劃時,給效能測試一個正式的位置,會是對這份投資最好的回報。
七、小結:上半場結束
三十天的系列走完了一半。上半場的成果用一句話總結:你已經能安全、專業、有紀律地完成效能測試的執行面——從生成腳本、模擬真實流量到除錯善後,而且每一步都驗證得動。12 條檢查清單是上半場的結晶,快問快答是你的地基檢測,還不會的那張清單則是下半場的預告。休息一天也好,把清單貼在螢幕旁也好——下半場開始,我們從「會做」走向「會判讀、會說服」。
附錄:效能測試腳本檢查清單(影印版)
□ 1. 五要素齊備且註解說明(對象/人數/時長/驗證/間隔)
□ 2. 有 think time,已隨機化,範圍有依據
□ 3. check 至少含狀態碼,且曾故意弄壞驗證過
□ 4. thresholds 已訂,來源是 SLO 或實測基準
□ 5. 無寫死機密;網址走 BASE_URL 環境變數
□ 6. URL 帶參數已分組;group 名稱固定
□ 7. 測試資料已參數化,不是全員同一筆
□ 8. 唯一值帶 PERF_ 類可辨識前綴
□ 9. 寫入型操作有清理策略(teardown 或依前綴可清)
□ 10. 登入模式(共用/各自)是有意識的選擇
□ 11. 能用 1 VU smoke 跑過,checks 全綠
□ 12. 檔名講人話;README 已更新;五問答得出


 iThome鐵人賽
 看影片追技術